Raft 源码学习:一个 Agent 如何成为长期协作的参与者
本文由 AI 撰写,仅用于学习和理解 Raft 源码。从一条频道消息出发,跟踪 Agent 的身份、执行过程、文件记忆、任务协作和凭据边界。
本文由 AI 撰写,仅用于学习和理解 Raft 源码。从一条频道消息出发,跟踪 Agent 的身份、执行过程、文件记忆、任务协作和凭据边界。
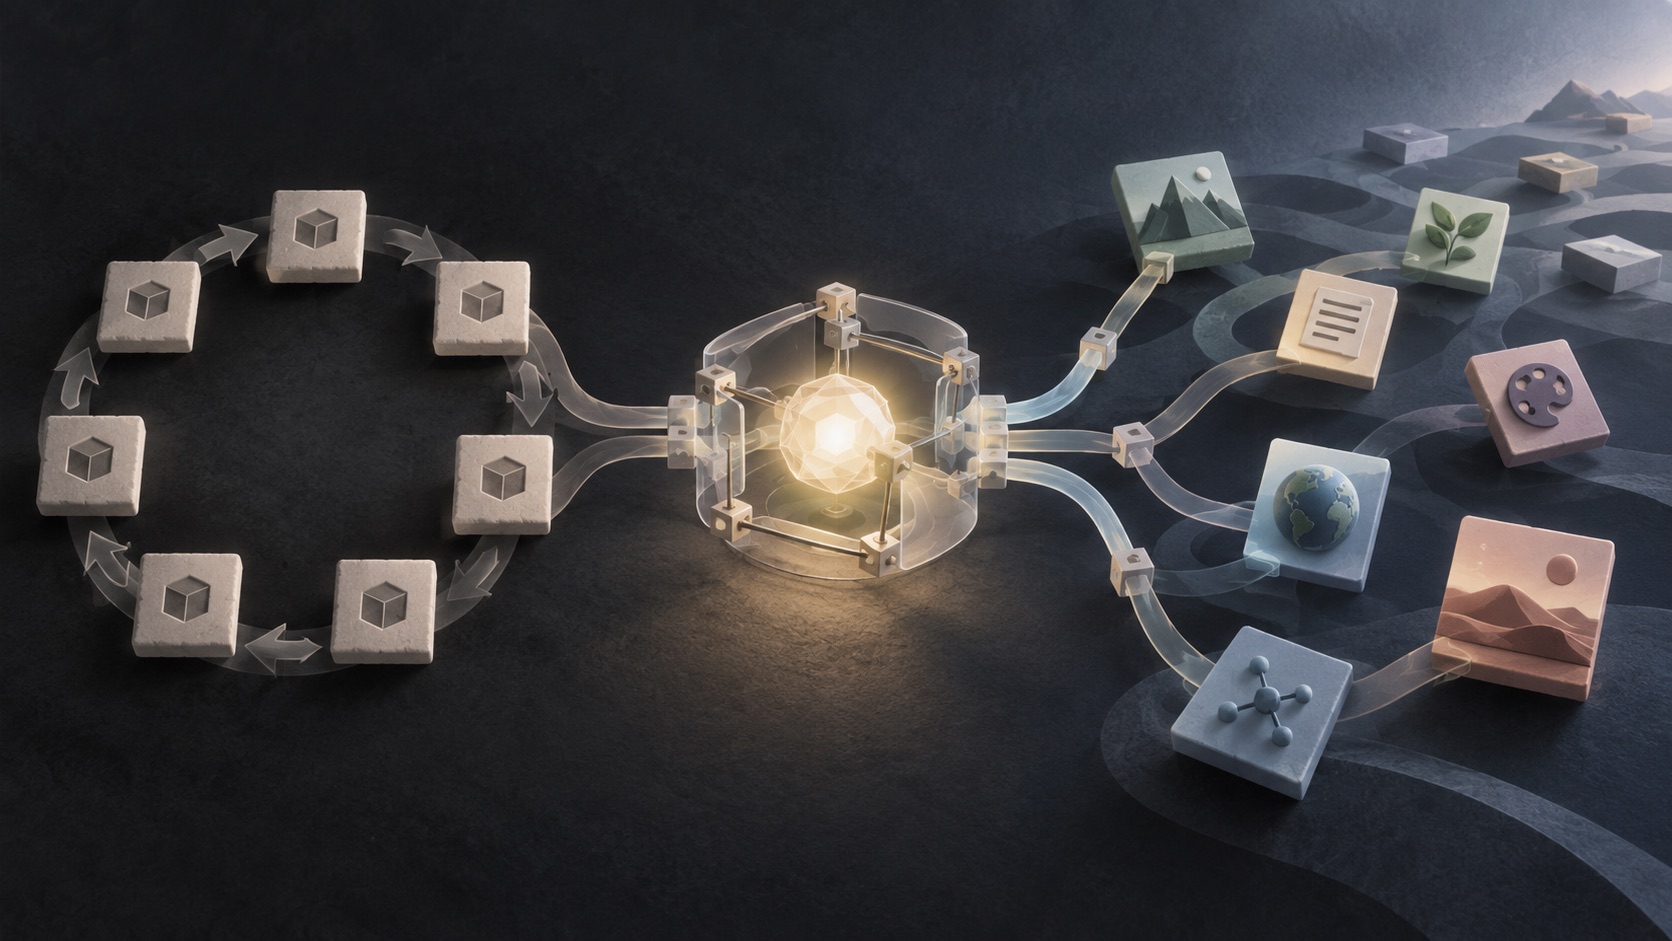
本文仅用于学习和了解新项目,正文由 AI 撰写。 同一个大模型,换一套提示词、工具说明、上下文压缩和错误恢复逻辑,完成任务的能力就可能明显不同。这些围绕模型的程序与配置,通常被叫作 Agent 的 Harness。 既然 Harness 可以由人修改,也可以让另一个 Agent 读失败记录、改代码、跑评测,反复寻找更好的版本。但这里有一个熟悉的陷阱:如果每轮都拿同一批题挑赢家,系统可能学会的是这批题的答案,而不是可复用的做事方法。 RRSI: Regularized Recursive Self-Improvement of Agent Harnesses 研究的就是这个问题。它保持底座模型权重不变,让系统自动修改 Harness,同时约束“提出改动”和“接受改动”两个环节,目标是让提升能迁移到没参加演化的任务。论文于 2026 年 9 月 21 日发布,目前是 arXiv 预印本。 先弄清楚:它在改什么 这里的“递归自我改进”不是模型自己训练出一组新权重。论文中的改进对象是模型外面的 Harness,包括提示词、控制流程、工具、技能、记忆、子 Agent 和上下文管理。 一个普通的自动演化循环可以写成: 1 2 3 4 5 6 当前 Harness → 在一批任务上运行,收集失败轨迹 → 让 LLM 提出几个代码或配置改动 → 用同一批任务给候选版本打分 → 保留分数最高的版本 → 下一轮继续 问题出在“同一批任务”被反复使用。候选改动、失败分析和下一轮提案都看过前几轮的反馈;即使评测脚本没有泄露答案,搜索过程也在持续适应这份有限的题集。一个专门识别某类题面、不断追加提醒、或者在某个评分器前写出讨喜格式的 Harness,可能越考越高,却不能帮助新的任务。 论文把演化时反复使用的任务称为 evolve set。它还区分两种没参与调参的测试:同一基准里的留出任务(ID held-out),以及任务形式或评分方式不同的其他基准(OOD)。真正值得看的不是 evolve set 提升多少,而是离开这批题后还剩多少。 ...
本文仅用于学习和了解新项目,正文由 AI 撰写。 写一个能调用大模型和工具的 Agent 并不难,难的是让一万个 Agent 安全、稳定、便宜地跑起来。 本地演示里,Agent 往往只是一个 Python 或 TypeScript 进程:读提示词、调用模型、执行工具、输出结果。但进入生产环境后,问题很快会变成:代码应该在哪运行?它能访问哪些仓库和网站?闲置半小时还要不要占着一整台机器?进程被中断后能不能接着工作?怎样同时管理成千上万个执行中的 Agent? Google AX 想解决的就是这一层问题。它把自己定义为一个面向 Agent 工作负载的声明式编排器:你提交一份类似 Kubernetes 清单的 YAML,AX 负责准备工作区、建立网络边界、启动隔离环境,并管理任务的暂停、恢复和销毁。 它不是教 Agent 如何推理的框架,也不是封装模型 API 的 SDK。更准确地说,Agent 框架负责“大脑”,AX 负责“工位、门禁和运行制度”。 本文基于 2026 年 9 月 22 日的 AX main 分支与项目官网撰写。项目接口仍是 v1alpha1,官方明确提醒稳定版之前可能有重大变更。 为什么 Agent 不是普通微服务 微服务通常持续监听请求,资源需求相对稳定;批处理任务则从头运行到尾,结束后退出。Agent 同时不太像这两者。 一个 Agent 可能先高强度运行几分钟,然后等待模型、外部工具或人工审批;它会修改文件、积累上下文和中间结果;它可能递归拆出子任务;它还会执行模型生成的代码,并访问网络。换句话说,Agent 往往同时具有四个特点: 有状态:工作区、进程和中间产物都可能影响下一步。 突发式计算:真正消耗 CPU 的时间不连续,大量时间在等待。 长生命周期:一次任务可能跨越数小时甚至数天。 高风险权限:它可能执行不可信代码、读取凭证、访问外部服务并持续花钱。 如果每个等待中的 Agent 都独占一个容器或虚拟机,资源利用率会很差;如果所有 Agent 又都挤在一个进程里,隔离、故障恢复和权限控制会变得非常困难。 AX 的判断是:Agent 需要一种新的调度单位。它应该像容器一样可以隔离,像进程一样轻量,还能在等待时保存状态并暂停。 四个原语:工单、工位、门禁和模型配置 AX 没有试图描述 Agent 的每一次思考,而是只提供四个基础资源。 ...
本文整理自与 ChatGPT 的一次讨论。问题是:Hermes Agent 这种、执行完 session 就触发创建 skill 的机制,真的好吗?下面按 NousResearch/hermes-agent 当前 main 上的实现来写。 自动从执行经验里长出 skill,这个方向是好的。Hermes 现在的默认机制偏激进。它不是「每次 session 跑完就总结成一条 skill」,但一次复杂经历仍然可以在没有复用验证的情况下,直接变成持久的程序性记忆。 它实际在什么时候动手 固定流程不是: 1 session end → create skill 更接近: 1 2 3 4 5 6 对话循环里的工具迭代累计 → _iters_since_skill >= creation_nudge_interval → 这一轮有最终回复,且没有被打断 → 主回复已经交付 → 后台 review agent 拿对话快照再看一遍 → 更新已有 skill / 加参考文件 / 新建 skill / 什么都不写 turn_finalizer.py 在回合收尾时检查: 1 2 3 agent._skill_nudge_interval > 0 and agent._iters_since_skill >= agent._skill_nudge_interval and "skill_manage" in agent.valid_tool_names 过线之后才 _spawn_background_review(..., review_skills=True)。还要同时满足:已经有 final_response、这轮没有被打断、没有 skip_background_review。cron 一类没有人在环里的运行会把后台 review 关掉。注释写明,review 放在交付之后,避免和用户正在等的任务抢资源。 ...
本文整理自与 ChatGPT 的一次讨论。讨论的出发点是:有一个很贵的 API,调用一次可能要 100 美元。这种调用不该由 Agent 自己决定要不要打,必须由人明确审核;审核结果 Agent 不能模拟,也不能伪造。 普通对话框里的 “Yes” 解决不了这个问题。Claude Code 那种逐条权限确认,拦的是本地命令和文件写入,人就坐在同一台机器前。100 美元一次的外部 API 要的是另一条边界:人在模型碰不到的地方,对这一次、这一组参数、这一笔金额签字,执行层只认这张签字。 这件事更准确的名字是带外人工授权(out-of-band human authorization)。Human-in-the-loop 只说明“环里有人”,没有说明这个人的同意能不能被模型伪造。 模型只能提出调用 安全边界要拆成四段,而且后三段都不能跑在 LLM 里面: flowchart TD Agent["Agent / LLM 提出 expensive_api"] --> Gateway["Authorization Gateway / MCP Server"] Gateway --> Policy{"Policy Engine 这笔请求是否允许进入审批"} Policy -- "拒绝" --> Deny["直接失败,不建审批单"] Policy -- "需要人批" --> Request["创建 approval_request 冻结 tool、参数、金额、request_id"] Request --> Pause["暂停,不调用 API"] Pause --> Human["独立 Approval Service Web / App / Slack / 推送"] Human -- "人批准" --> Cap["签发一次性授权"] Cap --> Check["Gateway 验签、验绑定、验未使用"] Check -- "全部匹配" --> API["expensive API"] Check -- "任一不匹配" --> Deny 四段各自只做一件事: ...
微软发了个postgresql插件pg_durable 可以用sql编排工作流,还能保证执行完成!太厉害了,待我玩一玩
本文是阅读这篇博文后的简单记录与思考: How we built Claude Code auto mode: a safer way to skip permissions 使用Claude Code时,经常会遇到各种权限的申请,也就是human-in-the-loop,导致提了一个复杂需求给CC后,如果人离开电脑了任务就会卡在这个申请上。所以网友各种hack,使用happy或者是远程登陆软件连到自己电脑上。 CC官方新增了auto mode功能,尽可能的利用AI的能力来帮助简化审批流程。避免--dangerously-skip-permissions带来的灾难性破坏 为什么可以做 系统基于一个数据前提:CC用户通过了93%的权限申请。 这是一个很关键的前提条件,他给auto mode的实现提供了很大的可能性:仅有很小比例的情况下是需要拒绝的,如果反过来CC用户通过了7%的权限申请。,那么auto mode需要处理的情况就复杂的多了。 怎么做的 prompt注入探针 CC团队在server端实现了一个运行在服务器端的prompt注入探针,它扫描tool消息,并在发现风险时插入warning消息 为啥需要这个prompt注入探针?原因是两层决策机制没有把tool result作为输入,这可能导致prompt注入成功,这时候如果有warning消息,则agent被劫持的概率会大大降低。 两层的决策机制 在client端实现了两层的决策机制,使用Claude Sonnet 4.6 进行判断,第一层是简单输出是否拦截,当拦截时进入第二层,使用更多的reasoning token来给出更准确的判断。输入是user消息+tool消息,干掉了assistant消息和tool result 为啥是两层?因为大部分情况下不会拦截,当第一层拦截时再花费更多token去进行判断。效果是一样的,可以节省更多成本。 为啥干掉assistant消息和tool result?因为assistant消息可能会误导LLM,tool result可能会含有注入的有毒信息 结合服务端与客户端的两种自动审查,劫持主agent会变得很难 auto mode下拦截后发生了什么 不执行tool,并提示模型:find a safer path, don’t try to route around the block. 如果连续三次被拦截,或者是累积20次被拦截,则让人类来决策 如果是headless模式,则退出执行 这还挺聪明的,如果发生了拦截了不该拦截的tool调用,则多次重试可以将false positive的情况降到最低 怎么评价,结果怎样 先看效果:日常流量的误拦率从 8.5% 压到了 0.4%,但 overeager 动作还是有 17% 会漏过去。 为啥漏拦这么高?因为难点不在「看没看见危险」,而在「用户到底授没授权」。force-push、删分支模型都识别得出来,但「清理一下分支」这句话算不算允许批量删除?分类器在这条边界上经常拿不准,prompt 工程暂时也没招。 那它到底值不值得用?得看跟谁比。跟 --dangerously-skip-permissions 裸奔比,这是实打实的进步;跟逐条认真审批比,反而是退步——你把自己的判断换成了一个会偶尔出错的分类器。所以它不是给所有人的,而是接住前文那批被 approval fatigue 折磨、又不敢裸奔的用户,做 happy 这类 hack 的官方替代品。
RAG(Retrival Augumented Generation)技术对于扩充模型的知识,减少幻觉,提高实用性上非常重要。这篇文章主要是介绍一个RAG系统的各个工作环节,对应的可调节参数以及应用场景。 RAG系统的工作流程 Ingestion parsing(pdf html) chunking metadata 来源、标题、章节、日期、权限 contextual retrieval Vector db indexing dense model choice 模型维度、语言支持、是否非对称 sparse / bm25 indexing embedding/index 的更新机制 Retrieve Query processing rewrite expand HyDE query routing metadata filtering Hybrid search 融合 RRF 或加权 rerank 上下文压缩 / 去重(把检索到的内容裁剪、去冗余,省 context window) chunk 扩展(检索命中小 chunk,但喂给 LLM 时取回它的相邻上下文或父文档,即 “small-to-big” / parent-document retrieval) Generation no-answer / 兜底 prompt 拼装(把 query + 检索结果组织成 prompt) 生成 citation / attribution(标注答案出自哪个 chunk,可溯源) ...
MiroThinker 1.7 在长问题推理领域取得了SOTA的成绩,优秀的成绩是由强Model与扎实的Harness共同组成的,本文是对其Harness实现中的关键工程优化的记录。 前置背景 MiroThinker 是一个深度研究型 Agent —— 给一个复杂问题(“今天 arxiv 上 cs 的论文标题是什么”),它会自己拆任务、搜索、抓网页、跑 Python 验证,最后输出 \boxed{答案}。底子是经典 ReAct:每回合 LLM 思考 + 工具调用,结果回写历史,循环 200~300 次直到收敛。 256K 上下文 + 单任务最多 300 次工具调用,对工程是不小挑战。运行时整体长这样: flowchart TD Task["task_description (用户问题)"] --> Loop subgraph Loop ["Orchestrator 主循环 (≤200/300 turns)"] direction TB For["for turn in 1..max_turns:"] S1["① LLM 思考 → tool_call"] S2["② ToolManager → MCP Server (search / python / scrape / ...)"] S3["③ keep_tool_result:裁剪远端工具结果"] S4["④ ensure_summary_context:token 预估刹车"] S5["⑤ rollback / 中间答案池"] For --> S1 --> S2 --> S3 --> S4 --> S5 end Loop --> Condition{"结束条件"} Condition -- "成功 \boxed{}" --> Success["输出最终答案"] Condition -- "跑满 / 上下文满" --> Failure["generate_failure_summary"] Failure --> Restart["重启 attempt(≤3 次)"] 下文按"护栏机制 → 工具层 → 上下文处理"三块展开。 ...
本文是 Claude Code 源码逆向系列 的第二篇,聚焦 Skills 发现与 System Prompt 注入机制。 我最先关心的问题是:AGENTS.md 里的规则到底怎么进入模型上下文? 恢复后,这条链路大致是: src/core/skills/agentsFile.ts:从工作目录向上查找并读取 AGENTS.md src/core/skills/prompt.ts:解析可用 skill,并构造可注入的 prompt 片段 src/core/model/request.ts:把 skills prompt 追加到 system 消息块 src/core/tools/skill.ts:提供内置 Skill 工具,支持运行时查询/加载 一个典型的 TS 片段(示意,保留结构)是这样的: 1 2 3 4 5 6 7 // src/core/model/request.ts if (params.skills && params.skills.trim()) { systemBlocks.push({ type: "text", text: params.skills, }); } 对应伪代码: 1 2 3 4 skillsPrompt = discoverSkillsFromAgentsFile(cwd) if skillsPrompt exists: append skillsPrompt into system messages send request to model 这块我有个明确取舍:先把 Skills 恢复成独立模块,不急着耦合进 runCli 主流程。原因很简单,Skills 的输入输出边界很清晰,独立后更容易做逐步校验,也更适合后续替换解析策略。 ...